林丹职业生涯数据被反复拿来讨论边界指标是否适用,这件事值得关注。原因不在冠军数量,而在他的样本跨越规则调整、年龄变化和高强度赛事。一个指标在常规区间看似稳定,到了林丹这样的长周期样本边界处,就容易暴露定义含混和口径漂移。边界指标能否解释真实比赛,直接关系到数据解读的可信度。
公开比赛记录整理者把林丹的局分、技术统计和关键分逐场录入,形成事件级数据库。录入时保留赛事名称、对手排名、比赛轮次和局间休息,避免只留胜负结果。这样做的目的是让每个指标都能回溯到具体回合,而不是把整场比赛压成一老哥俱乐部官方网站个平均数。数据库还标注了退赛、伤病和临时换拍等异常记录。
指标定义先围绕进攻效率、防守覆盖和关键分胜率展开,再按赛事级别与对手强度分层。进攻效率不只看杀球得分,还看杀球后下一拍是否失位。防守覆盖结合跑动方向和回球质量,避免把被动救球误判为稳定防守。关键分胜率则限定在局末分差两分以内,减少无关回合干扰。
规则边界最先显现。林丹早期经历十五分制,后期进入二十一分制,发球权与得分方式改变,回合长度和发接发策略随之变化。把两个时期的得分率直接比较,会把规则红利误当成能力增长。更稳妥的做法是按规则分段建模,再在共同指标上做桥接,而不是强行拉平所有数据。
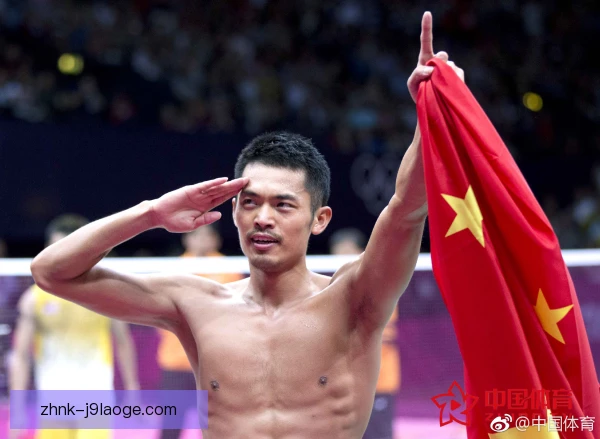
年龄边界同样关键。林丹巅峰期的启动速度和连续突击能力突出,后期体能分配更谨慎,经验却让网前选择和落点控制更精细。若用固定阈值判断状态,后期数据会被简单判为下滑。更合理的方式是滚动时间窗口,把体能指标与决策指标分开看,允许不同年龄段拥有不同权重。
对手边界让指标解释更复杂。林丹面对李宗伟时多拍拉锯和防守反击比例高,面对谌龙时后场强攻和头顶区争夺更密集。同一套杀球效率在两种对手结构下含义不同。若不控制对手风格与排名,所谓林丹边界指标很容易把对手强弱差异误读成自身能力变化。
赛事边界体现在压力与样本量上。全英公开赛历史悠久,世锦赛和奥运会淘汰更残酷,汤姆斯杯与苏迪曼杯又牵涉团体责任。林丹在奥运会关键分的决策权重明显高于普通公开赛。把不同赛事的关键分胜率混在一起,会让高压力场景的波动被平均掉,边界指标的警示意义随之减弱。
样本偏差是回看林丹数据时绕不开的问题。只保留冠军场次和高光回合,会高估关键分能力,也会掩盖伤病期的低效选择。退役后公开数据整理往往偏向完整赛事,退赛和低级别比赛记录不全。若不做缺失机制说明,边界指标看起来精确,实际可能建立在被筛选过的样本上。
因果解释需要克制。林丹某场杀球得分率很高,可能因为对手防守弱,也可能因为他减少了冒险进攻。把相关性直接写成能力提升,会误导训练决策。方法上应控制回合长度、对手排名、比赛阶段和比分压力,再观察指标变化是否仍然稳健。边界指标只有放进条件模型,才有解释力。
稳健性检验应成为林丹数据解读的常规步骤。换一个时间窗口,边界指标的排名可能改变;换一种对手分层,关键分胜率可能不再显著。研究者需要公开异常值处理、缺失值填补和模型选择过程。用多个模型互相验证,比给出一个漂亮却脆弱的结论更有价值。
边界指标误用会带来现实影响。青训选材若照搬林丹后期数据,可能忽视年轻球员的爆发力和恢复速度;舆论评价若只看关键分胜率,也容易把团体赛责任和伤病因素抹掉。中国羽毛球队在使用数据辅助训练时,需要把指标放回具体位置和比赛任务。否则数据越细,误读反而越像专业判断。
方法改进可以从分层模型入手。把规则、年龄、对手风格、赛事级别作为协变量,让林丹每个阶段的指标拥有各自基线,再比较相对变化。输出区间而不是单点,能提醒使用者边界处的不确定性。模型还应保留可解释项,让教练看懂哪些变量在起作用,而不是只得到一个黑箱评分。
可解释性最终要回到羽毛球情境。林丹在关键分选择推挑还是强攻,取决于对手站位、体能和当日手感,单一比率很难完全承载。数据解读应把技术统计与比赛视频、教练记录和运动员自述结合。边界指标适合提示异常,不适合替代专业判断。把异常当作线索,才能继续追问原因。
林丹数据的真正意义,在于把边界条件摆到台面上。任何指标都有适用区间,跨规则、跨年龄、跨对手、跨赛事使用时,必须重新检验。中国羽毛球队若能把这类长周期样本转化为方法资产,训练监控和赛后复盘会更稳。公开讨论指标局限,不会削弱林丹的历史地位,反而让评价更接近比赛真实。
往后看,公开数据越细,边界指标越需要方法纪律。林丹这样的长周期样本会继续被用于检验指标稳健性,也会暴露更多口径争议。研究者应把结论写成条件判断,说明在何种规则、年龄和对手结构下成立。读者也应保持耐心,先问指标从哪来,再看它指向什么。